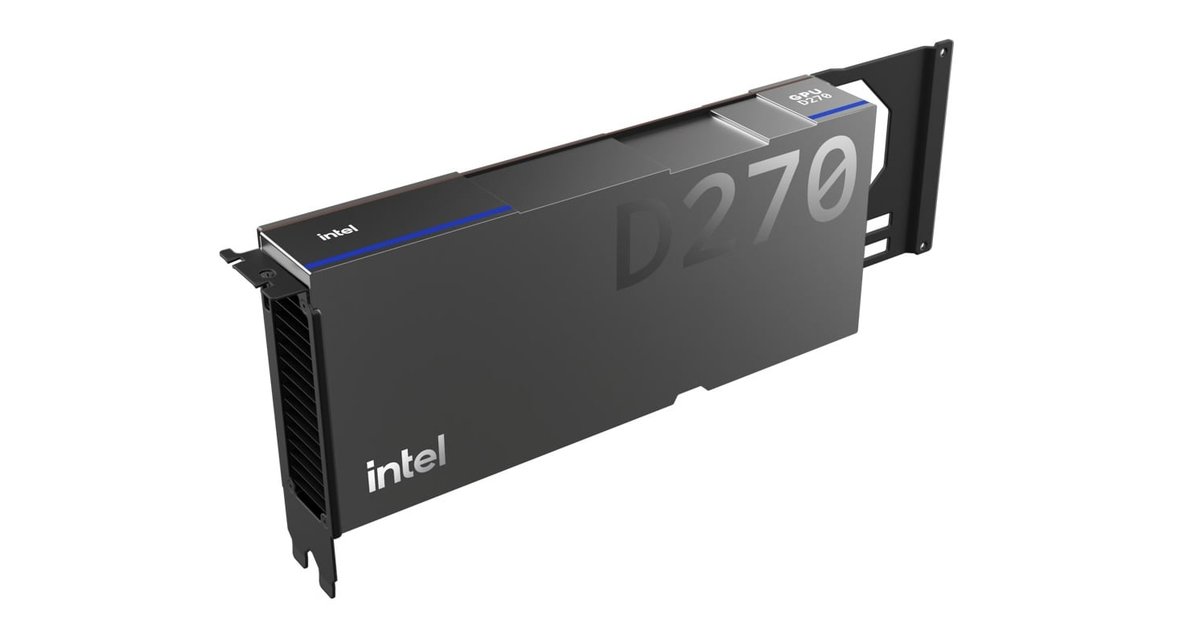
2026 年 10 月 12 日至 13 日,在 OCP 全球峰会上,Intel 给代号 Crescent Island 的推理加速卡定了正式名字:Intel GPU D 系列。最唬人的一条规格是:单卡最高 480GB LPDDR5X 显存、1.5TB/s 带宽、1.3 PFLOPS FP8 算力,整卡功耗 350W,风冷。
这不是一张用来训练的卡,也不是一张用来打游戏的卡。它瞄准的是一个很具体的问题:模型越来越大、上下文越来越长,显存先不够用了。
一、480GB 是怎么来的
D 系列基于 Xe3P 架构,32 个 Xe 核心、256 个 XMX 引擎。和主流 AI 卡最大的不同,是它没有用 HBM,而是用了 LPDDR5X。480GB 是合作伙伴版本的上限,Intel 自有品牌卡是 160GB。
用 LPDDR5X 换来了三件事:容量大、成本相对低、能塞进风冷机架。代价也很直接:带宽只有 1.5TB/s,而 Intel 自家 Gaudi 3 用 HBM2e,128GB 容量、3.7TB/s 带宽。一个偏科在容量,一个偏科在速度。
为什么容量重要?大模型推理的瓶颈常常不是算力,而是显存:权重、KV Cache、长上下文都要占地方。官方口径是单卡可支持 3000 亿参数模型,8 卡系统超过 1 万亿参数。对做私有化部署的企业,这意味着一些过去必须上多机多卡的模型,现在可以放进一台风冷服务器。
二、配套的不只是卡
Intel 同时给了机架侧的方案:Xeon 6+ 最高 288 核,一个机架可以放 160 个插槽、超过 46000 个核心,整柜功耗 133.45kW。这个数字听起来夸张,但它描述的是“智能体流水线”的 CPU 侧——token 路由、检索、数据库查询、代码执行,都属于这类负载。
生态方面,ASRock Rack、华硕、技嘉、MiTAC、微星、超微都有现成系统,其中三款是 ORv3 机架,其余是 19 英寸机箱。Intel 还和 AMD、戴尔、NVIDIA、高通一起在 OCP 推动 Open Adapter Card 规范,想让不同厂商的加速卡能插进同一个开放机箱。

三、三个判断
- 推理卡开始分叉。训练看算力和互联,推理看容量和成本。D 系列是后一种思路的典型产品:不追求峰值,追求“一张卡能装下多少”。
- 软件是短板,也是变量。Intel 的 oneAPI、IPEX 生态在进步,但和 CUDA 的差距仍在。D 系列首日支持 Meta 的 30B 开源模型,说明它在补“开箱即用”这一课。
- 350W 风冷是给存量机房准备的。不是每个机房都能上液冷。350W、PCIe 形态意味着它可以进标准服务器,这对预算有限的企业比峰值算力更有吸引力。
四、谁该关注,谁可以跳过
| 场景 | 建议 | 理由 |
|---|---|---|
| 私有化部署 70B–300B 模型 | 重点关注 | 单卡 480GB 能减少卡数,降低整机与功耗成本 |
| 长上下文 / RAG / 多路并发 | 适合 | 容量换并发,KV Cache 更从容 |
| 大模型训练 | 不适合 | 带宽和互联不是为训练设计的 |
| 追求最低时延的在线推理 | 先对比 | LPU、高端 GPU 在时延上仍有优势 |
| 现有 CUDA 重度用户 | 谨慎 | 迁移成本要算进总拥有成本 |
五、对广州企业的采购提示
- 先算显存,再算算力。把模型参数量、量化精度、上下文长度、并发数写清楚,倒推需要多少显存,而不是先看 TOPS。
- 问清 160GB 和 480GB 的差别。Intel 自有卡和合作伙伴卡的容量不同,报价和交期也会不同。
- 确认软件栈。vLLM、PyTorch、OpenVINO 的版本支持,最好让供应商现场跑一遍你的模型。
- 别忽略电力。350W 单卡看似温和,8 卡整机加 CPU、内存、网络,机柜功率仍然要重新核算。